2교시의 도착점
테스터의 취향을 평균내는 대신, 제작 의도와 실제 행동 사이의 차이를 재현 가능한 기록으로 남기는 방법을 익힙니다.
- 01
디버깅·수용 검사·플레이테스트의 질문이 어떻게 다른지 구분합니다.
- 02
세 사람에게 같은 빌드·같은 과제·같은 질문을 제공하는 이유를 설명합니다.
- 03
관찰·해석·해결책을 섞지 않고 기록합니다.
- 04
영향과 빈도로 문제 하나를 고르고, 최소 수정과 회귀 검사로 닫는 절차를 설명합니다.
60분의 설명과 시연 흐름
정답을 보여 주기 전에 학생에게 무엇을 기록하고 무엇을 고칠지 묻습니다. 그 뒤 교수자의 샘플 기록과 비교합니다.
추측을 증거로 바꾸는 한 사이클
Lecture & demo / professor-led
- 검사 질문 구분
버그가 없는가, 요구 기능이 작동하는가, 다른 사람이 의미를 이해하는가는 서로 다른 질문임을 비교합니다.
- 실험 조건 잠금
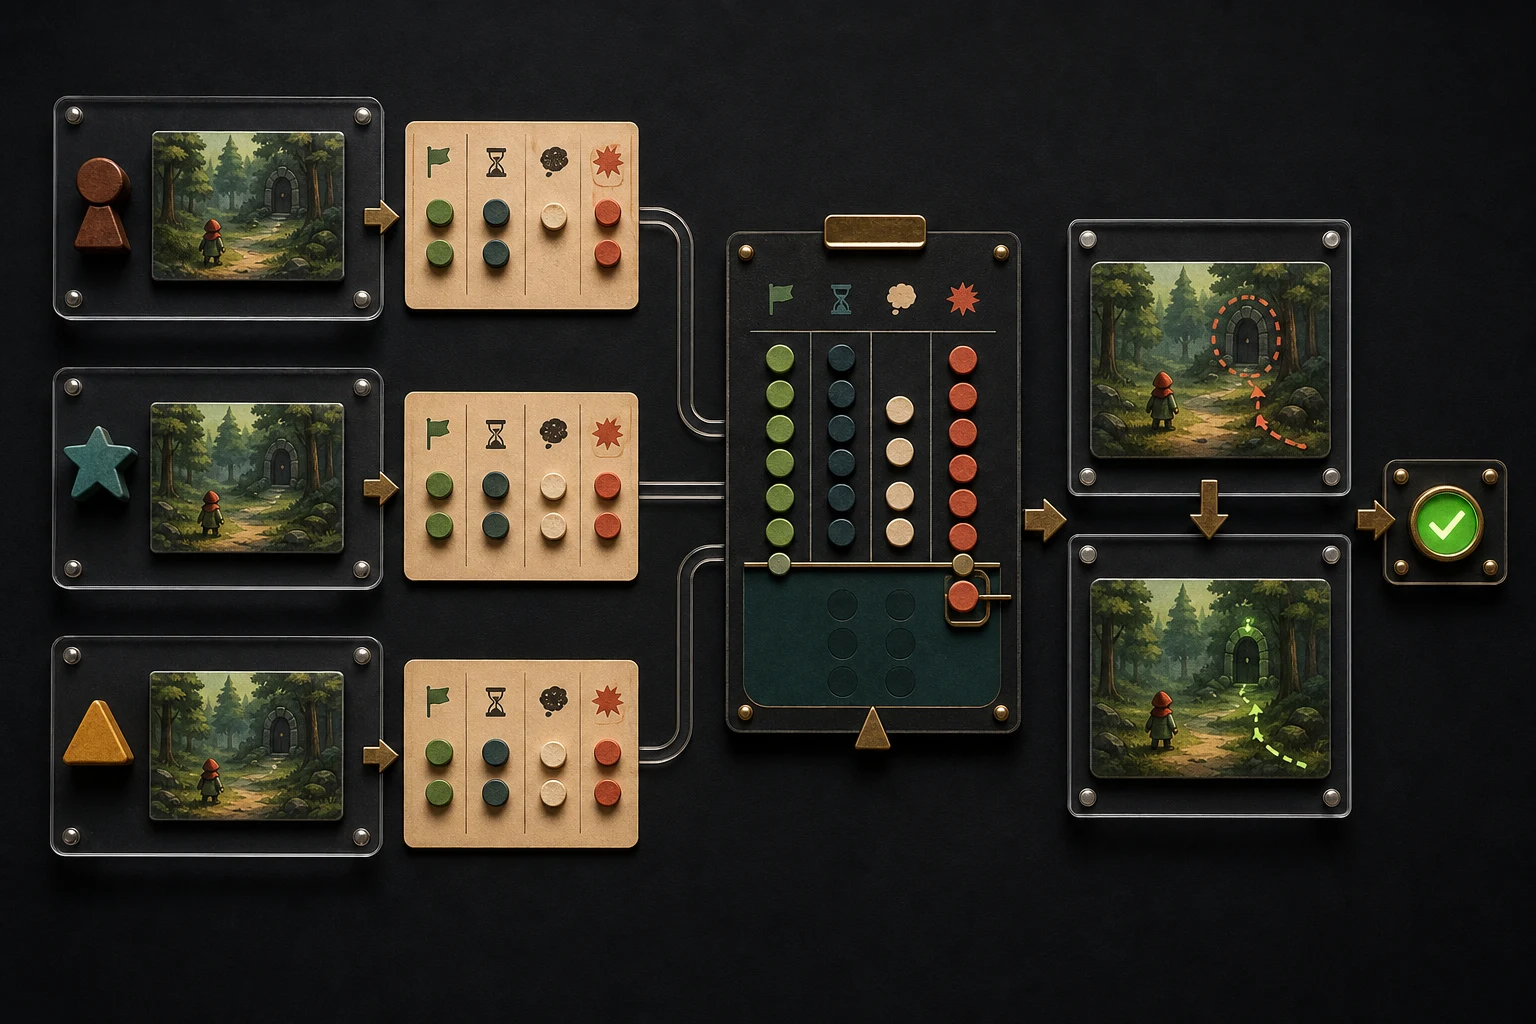
학습 질문 하나, Alpha v0, 2분 과제, 관찰 항목과 사후 질문을 테스트 전에 고정합니다.
- blind run 시연
설명을 멈추고 첫 시도를 관찰하며 성공 여부, 시간, 첫 망설임과 막힌 지점을 사실 문장으로 기록합니다.
- 세 기록 비교
관찰과 해석을 분리하고, 반복된 행동을 하나의 문제 군집으로 묶습니다.
- 문제 하나 최소 수정
경험 영향과 관찰 빈도가 큰 문제를 고르고, 새 기능 없이 가장 작은 UI·사운드·조건 수정만 적용합니다.
- 재빌드와 회귀 검사
같은 과제로 수정 효과를 확인하고, 기존 핵심 루프가 깨지지 않았는지 Alpha v1 build에서 다시 검사합니다.
세 검사는 서로 다른 실패를 찾습니다
한 번의 플레이에서 모든 것을 평가하려고 하면 기록이 흐려집니다. 먼저 어떤 질문에 답하는 검사인지 정합니다.
- 질문
- 예상하지 못한 오류가 발생하는가?
- 증거
- 재현 순서, Console, stack trace, 잘못된 값
- 예시
- 목표에 도착해도 NullReferenceException으로 결과 화면이 열리지 않음
- 질문
- 정해 둔 요구 기능이 기대 결과를 만드는가?
- 증거
- 입력·조건·기대 결과·PASS 또는 FAIL
- 예시
- 수집물 3개 뒤 목표에 들어가면 Won 상태와 재시작 버튼이 표시됨
- 질문
- 설명 없이 목표·상태·다음 행동을 이해하는가?
- 증거
- 행동, 완료 시간, 망설임, 막힘과 사후 응답
- 예시
- 세 명 중 두 명이 목표 문을 장식으로 보고 지나침
- 질문
- 목표 기기 build에서 느림·끊김의 실제 원인이 무엇인가?
- 증거
- Profiler의 CPU·GPU·Memory 측정과 재현 구간
- 예시
- Editor 느낌이 아니라 Development Build의 특정 구간에서 frame spike 확인
세 사람에게 같은 조건을 제공합니다
테스터마다 설명과 질문이 달라지면 결과 차이가 게임 때문인지 진행자 때문인지 알 수 없습니다. 빌드와 문장을 먼저 잠급니다.
Week13_Alpha_v0첫 세 세션이 끝날 때까지 Scene, UI, Audio와 Script를 수정하지 않습니다.
게임을 시작해 목표를 찾아 한 판을 끝내고, 가능하면 다시 시작해 달라고만 말합니다.
2분 플레이, 짧은 사후 질문, 기록과 reset을 같은 순서로 진행합니다.
- 01
목적과 개인정보 범위를 알립니다
“사람이 아니라 게임 안내를 검사합니다. 이름은 적지 않고 A·B·C로만 기록하며, 이번 수업에서는 화면과 음성을 녹화하지 않습니다.”라고 안내합니다.
통과 테스터가 중단할 수 있음을 알고, 기록표에 이름·학번·연락처가 없습니다.
- 02
과제를 한 문장으로만 제공합니다
조작법, 정답 위치와 제작 의도를 설명하지 않습니다. 무엇을 눌러야 하는지 묻더라도 최소 30초는 행동을 관찰하고 막힘을 기록합니다.
통과 세 명 모두 같은 문장으로 시작하고, 도움을 준 시점과 문장도 기록합니다.
- 03
말보다 행동을 먼저 기록합니다
완료 여부, 완료 또는 중단 시간, 첫 망설임, 반복 행동, 막힌 지점을 관찰 가능한 문장으로 씁니다.
통과 “답답해했다” 대신 “목표 문 앞을 세 번 지나고 18초 멈췄다”처럼 다시 확인할 수 있습니다.
- 04
같은 세 질문으로 닫습니다
“목표가 무엇이라고 생각했나요?”, “어디에서 가장 확신이 없었나요?”, “어떤 화면 변화나 소리가 결과를 알려 주었나요?”를 순서대로 묻습니다.
통과 유도 질문이나 디자인 해명이 없고, 필요한 경우 테스터의 말을 짧게 요약해 의미만 확인합니다.
본 것, 뜻한다고 추정한 것, 고칠 것을 분리합니다
좋은 기록은 해결책부터 쓰지 않습니다. 관찰 사실이 남아 있어야 다른 해석과 더 작은 수정도 검토할 수 있습니다.
| 층 | 질문 | 좋은 기록 | 피해야 할 기록 |
|---|---|---|---|
| 관찰 | 무엇을 보거나 들었나? | B는 목표 문 앞을 두 번 지나고 수집물 위치로 되돌아갔다. | B는 목표를 이해하지 못했다. |
| 해석 | 이 행동이 어떤 문제를 뜻할 수 있나? | 완료 가능 상태와 목표 문의 피드백 연결이 약할 수 있다. | 문이 나쁘다. |
| 해결 후보 | 가장 작은 변경은 무엇인가? | 마지막 수집 직후 목표 아이콘·문 윤곽·짧은 완료 준비음을 함께 바꾼다. | 전체 UI와 레벨을 새로 만든다. |
| 검증 | 변경 효과를 어떻게 확인하나? | 같은 과제에서 목표를 처음 찾는 시간과 재방문 횟수를 다시 잰다. | 전보다 좋아 보이면 완료한다. |
누가 + 어느 장면에서 + 무엇을 + 몇 번 또는 몇 초 동안 했는가의 형식으로 씁니다. 표정과 감정을 추정하지 않고 조작, 시선 이동, 멈춤, 되돌아감과 발화를 기록합니다.
영향을 먼저 보고, 빈도와 비용으로 범위를 줄입니다
세 명이 말한 모든 의견을 고칠 필요는 없습니다. 핵심 루프를 막는 문제를 먼저 처리하고, 이번 60분 안에 검증 가능한 한 가지로 제한합니다.
- P0 / BLOCKER진행 불가
crash, 조작 불가, 결과 상태 진입 불가처럼 한 판을 끝낼 수 없습니다.
- P1 / COMPREHENSION핵심 의미 불명
목표·피해·성공·재시작을 잘못 이해해 핵심 루프가 흔들립니다.
- P2 / FRICTION완료하지만 망설임
결국 진행하지만 반복 탐색, 불필요한 대기나 가독성 저하가 나타납니다.
- P3 / POLISH취향과 마감
진행과 이해에는 영향이 적은 색, 장식, 개별 선호입니다.
Alpha v0에서 v1까지 한 번만 통과합니다
교수자는 아래 여덟 단계를 끊지 않고 보여 줍니다. 학생은 각 단계 전에 다음 조작보다 다음 증거가 무엇이어야 하는지 답합니다.
- 01
v0를 복제하고 build를 고정합니다
작업 프로젝트를
Week13_Demo_v0로 복제하고 실행 build가 한 판을 완료하는지 확인합니다.화면 시작 build와 시간, checksum 또는 파일 수정 시각을 기록합니다.
- 02
학습 질문 하나를 선언합니다
“마지막 수집 뒤 목표 문이 활성화되었다는 사실을 플레이어가 알아차리는가?”처럼 관찰 가능한 질문으로 좁힙니다.
화면 목표를 찾는 시간과 문 앞 되돌아감 횟수를 기록 항목으로 정합니다.
- 03
세 blind run을 같은 문장으로 진행합니다
A·B·C의 성공, 시간, 첫 망설임, 막힘과 사후 응답을 각각 한 행에 기록합니다.
화면 세션 중 프로젝트를 고치거나 이유를 설명하지 않습니다.
- 04
관찰을 군집으로 묶습니다
목표 미인지, 결과 문구 미인지, 효과음 혼동처럼 행동이 가리키는 문제를 묶고 각 빈도를 셉니다.
화면 원문 관찰은 지우지 않고 별도의 해석 열에 군집명을 씁니다.
- 05
문제 하나를 승인합니다
영향·빈도·수정 위험을 말로 비교한 뒤 이번 수정과 미룰 항목을 구분합니다.
화면 선택 근거에 테스터 A·B·C 중 어떤 관찰이 연결되는지 표시합니다.
- 06
최소 변경만 적용합니다
새 mechanic 없이 목표 문 윤곽, HUD 상태 문구와 짧은 준비음을 같은 사건에 연결합니다.
화면 변경 파일과 GameObject를 시작 전 예상하고 끝난 뒤 diff와 비교합니다.
- 07
같은 질문으로 재검사합니다
가능하면 원 테스터 한 명이 같은 과제를 수행하고 목표 인지 시간과 되돌아감 횟수를 다시 기록합니다.
화면 “좋아졌다”가 아니라 같은 측정 항목의 전후를 비교합니다.
- 08
v1을 build하고 회귀 검사합니다
수집·피해·목표·성공·재시작과 음소거 상태를 다시 실행하고 수정 전후 화면을 저장합니다.
화면 수정한 문제 PASS와 기존 핵심 루프 PASS가 함께 있어야 완료입니다.
AI는 기록을 정리할 수 있지만 관찰을 만들 수는 없습니다
AI가 매끄러운 보고서를 만들었다고 플레이테스트가 된 것은 아닙니다. 사람의 실제 행동과 원문 기록이 먼저 있고, AI 출력은 그 증거에 다시 연결되어야 합니다.
- 설명
- 관찰과 해석이 섞인 문장을 찾아 이유 설명
- 점검
- 기록에서 빠진 조건·시간·기대 결과 질문
- 제한
- 익명화한 텍스트만 제공하고 프로젝트 수정은 요청하지 않음
- 범위
- 승인한 문제 하나의 최소 수정 순서 제안
- 예상
- 변경 파일·GameObject·위험과 회귀 목록
- 승인
- 학생이 근거와 범위를 검토한 뒤 실행 여부 결정
- 대상
- 이미 승인한 작은 Script 수정 한 건
- 권한
- 예상 파일과 최소 권한, diff 확인
- 검증
- build와 실제 재검사는 사람이 수행
- 조작
- 없는 테스터·시간·발화·PASS를 생성하지 않음
- 개인정보
- 이름·학번·얼굴·음성·연락처를 입력하지 않음
- 판정
- AI가 재미·성공 여부와 제출 완성을 대신 결정하지 않음
최적화는 느낌이 아니라 build 측정에서 시작합니다
에디터에서 느리다는 인상만으로 Texture와 Script를 무작정 줄이지 않습니다. 목표 플랫폼의 실행 build에서 재현 구간과 병목을 확인하고 가장 큰 원인 하나를 다룹니다.
- 01 / REPRODUCE구간 고정
시작, 첫 전투, 결과 화면처럼 끊김이 보이는 구간을 같은 조작으로 재현합니다.
- 02 / MEASUREtarget build 측정
Development Build와 Profiler로 CPU·Rendering·Memory 중 실제 spike가 있는 영역을 찾습니다.
- 03 / CHANGE ONE원인 하나 수정
대형 Texture, 과도한 instantiate, 중복 Update 호출처럼 측정된 원인 하나만 바꿉니다.
- 04 / COMPARE같은 구간 재측정
수정 전후 frame time과 증상을 같은 조건에서 비교합니다.
- 05 / RELEASE제출 build 분리
분석용 Development Build와 제출용 Release Build의 목적을 구분합니다.
13주차의 필수 성능 기준은 “목표 컴퓨터에서 알파 build가 시작되고 3-5분 핵심 루프 중 심각한 멈춤이나 crash가 없다”입니다. 고급 최적화 수치 경쟁은 하지 않으며 문제가 없다면 새 최적화를 만들지 않습니다.
3교시에는 같은 사이클을 각자 한 번 완주합니다
목표와 증거는 고정하지만 사운드 도구와 수정 방법은 선택할 수 있습니다. 세 명의 테스터는 관찰 데이터를 제공할 뿐, 제작 방향을 결정하지 않습니다.
시작·플레이·성공 또는 실패·재시작이 build에서 완료되어야 합니다.
같은 과제와 질문으로 세 번 진행하고 이름 없이 행동을 기록합니다.
영향과 빈도가 큰 한 문제만 고치고 새로운 mechanic은 추가하지 않습니다.
다섯 질문으로 시연을 복원합니다
학생이 다음 순서를 스스로 말할 수 있어야 3교시에서 교수자의 클릭을 기다리지 않고 목표를 향해 진행할 수 있습니다.
조건
세 테스터에게 반드시 같아야 하는 네 가지는 무엇인가요?
기록
“테스터가 혼란스러워했다”를 관찰 문장으로 바꿔 보세요.
우선순위
빈도가 낮아도 먼저 고쳐야 하는 문제는 어떤 문제인가요?
최소 수정
한 번에 여러 문제를 고치면 수정 효과를 설명하기 어려운 이유는 무엇인가요?
회귀
선택한 문제가 해결된 뒤 왜 기존 수집·피해·성공·재시작도 다시 검사해야 하나요?
플레이테스트와 build 검증 공식 자료
구조화된 사용자 검사와 성능 측정의 원칙을 수업 수준에 맞게 줄여 사용합니다.
- Unity Learn · User feedback and testing ↗목표·질문·세션 계획, 설명하지 않고 관찰하기, 동의와 기록 정책
- Unity Learn · Test your prototype ↗acceptance, exploratory와 user testing의 역할
- Unity · Testing and QA practices ↗functional, regression, performance와 player testing의 구분
- Unity 6.6 · Profiling applications ↗Editor 측정의 한계와 target platform build 측정
- Unity 6.6 · Build Profiles reference ↗Development Build, Autoconnect Profiler와 release build 구분